Tips Mengoptimalkan GPU untuk AI agar Stabil, Strategi Praktis Tingkatkan Kecepatan Pemrosesan
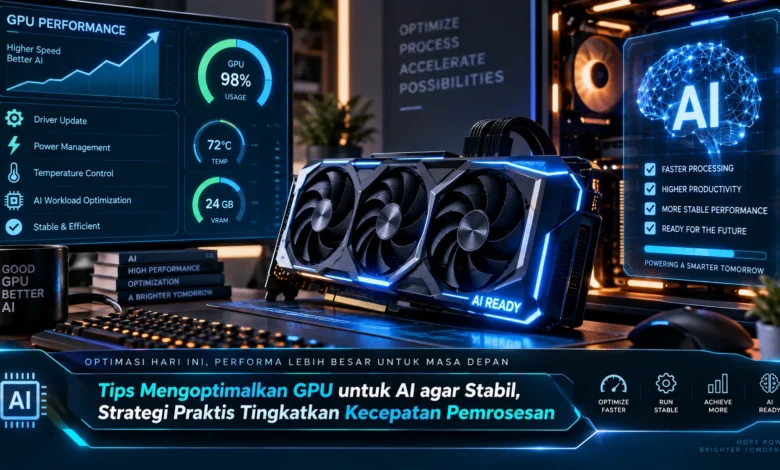
GPU menjadi komponen penting ketika menjalankan berbagai workload AI karena mampu menangani banyak operasi komputasi secara paralel. Namun, kartu grafis dengan spesifikasi tinggi belum tentu memberikan performa maksimal apabila VRAM, suhu, driver, framework, hingga konfigurasi model tidak dikelola dengan tepat. Optimasi yang seimbang dapat membantu meningkatkan kecepatan sekaligus menjaga stabilitas sistem, sehingga pemanfaatan TEKNOLOGI AI menjadi lebih efisien untuk inferensi maupun pekerjaan komputasi lainnya.
Identifikasi Kebutuhan Model Sebelum Mengubah Konfigurasi
Hal penting sebelum melakukan optimasi hardware adalah memahami karakter workload AI yang akan dijalankan. Setiap model dapat memiliki kebutuhan yang berbeda. Sebagian model lebih banyak membutuhkan kapasitas VRAM, sementara model lainnya lebih sensitif terhadap kemampuan komputasi atau kecepatan transfer data.
Pengamatan performa dapat memberikan gambaran mengenai beban sistem. Utilisasi GPU, penggunaan VRAM, aktivitas CPU, RAM, temperatur, serta kecepatan pemrosesan dapat dipantau pada saat aplikasi AI aktif. Apabila utilisasi kartu grafis rendah tetapi prosesor terus berada pada beban berat, bottleneck kemungkinan berada pada bagian lain dari sistem. Pendekatan tersebut membantu pengguna meningkatkan performa TEKNOLOGI secara lebih efektif.
Manajemen Memory GPU Menjadi Kunci Performa AI
Memory GPU merupakan komponen yang sangat berpengaruh dalam menjalankan model yang membutuhkan banyak parameter. Bobot model menggunakan sebagian kapasitas memory, sedangkan cache serta berbagai data pemrosesan menggunakan ruang lainnya. Jika seluruh kapasitas VRAM sudah digunakan sejak awal, stabilitas aplikasi dapat menurun ketika kebutuhan memory bertambah.
Pengguna dapat mengurangi aplikasi lain yang memakai akselerasi GPU. Browser dengan banyak tab, software desain, game, editor video, dan aplikasi multimedia berpotensi mengurangi memory yang tersedia untuk model. Menjaga agar kapasitas grafis tidak selalu penuh dapat mengurangi tekanan ketika model membutuhkan alokasi tambahan. Manajemen sederhana tersebut sering memberikan dampak nyata tanpa harus mengganti hardware.
Model AI Bisa Berjalan Lebih Efisien dengan Quantization
Quantization dapat menjadi strategi praktis dalam menekan konsumsi VRAM. Model yang menyimpan parameter dengan format numerik lebih berat cenderung mengonsumsi VRAM dalam jumlah lebih besar. Menerapkan format model yang lebih ringan dapat membuat model lebih mudah dimuat pada GPU.
Konfigurasi quantization perlu dipilih berdasarkan workload. Quantization yang semakin kuat mampu menekan kebutuhan VRAM lebih jauh, meski kualitas keluaran berpotensi terpengaruh pada sebagian model. Perbandingan beberapa tingkat precision dapat digunakan untuk mencari titik optimal berdasarkan perangkat. Fokus utamanya ialah menjaga keseimbangan antara penggunaan VRAM, kecepatan, dan hasil.
Konfigurasi Batch Size Membantu Menjaga Performa GPU
Konfigurasi batch ikut memengaruhi efisiensi pemrosesan. Memproses lebih banyak data secara bersamaan dapat memanfaatkan paralelisme GPU dengan lebih baik, meski tekanan terhadap memory GPU juga menjadi lebih besar. Memaksakan ukuran batch di luar kapasitas hardware dapat membuat sistem kehilangan stabilitas.
Jumlah context dapat memberikan pengaruh besar terhadap penggunaan sumber daya. Konteks yang luas dapat membutuhkan kapasitas memory tambahan. Ketika pekerjaan dapat diselesaikan menggunakan jumlah context yang lebih kecil, pengaturan yang terlalu tinggi dapat menambah beban tanpa manfaat sebanding. Menentukan nilai awal yang aman lalu menguji peningkatan secara perlahan dapat membantu menemukan titik performa yang stabil.
Kurangi Bottleneck dengan Pembagian Workload yang Tepat
Performa tinggi pada GPU belum tentu langsung menghasilkan pemrosesan cepat ketika komponen lain tidak mampu menyediakan data dengan cukup cepat. CPU dapat bertugas menyiapkan data sebelum diproses GPU, sementara RAM dan storage menyediakan informasi yang diperlukan. Jika salah satu bagian tersebut terlalu lambat, GPU dapat menunggu data meskipun memiliki kemampuan komputasi tinggi.
Offloading juga perlu dikelola dengan tepat. Apabila kapasitas memory GPU tidak mencukupi, offloading dapat digunakan agar workload tetap berjalan. Meski demikian komunikasi yang terlalu intensif antara CPU dan GPU dapat mengurangi manfaat performa GPU. Pembagian workload yang seimbang menjadi bagian penting dalam optimasi TEKNOLOGI AI.
Driver dan Pendinginan Menjadi Bagian Penting Optimasi GPU
GPU yang menjalankan workload AI dalam waktu panjang dapat bekerja pada suhu tinggi apabila sistem pendinginan kurang optimal. Apabila pendinginan tidak mampu menjaga kondisi kerja, GPU dapat mengurangi frekuensi agar temperatur kembali aman. Kondisi tersebut berpotensi menyebabkan performa turun setelah workload berjalan lama.
Airflow dan kebersihan perangkat menjadi bagian sederhana yang tidak boleh diabaikan. Driver serta framework AI juga perlu dijaga kompatibilitasnya. Perangkat lunak GPU, runtime AI, serta library yang bekerja dengan baik dapat membantu hardware mencapai performa lebih konsisten. Keseimbangan hardware dan software tersebut dapat meningkatkan keandalan TEKNOLOGI AI ketika digunakan secara intensif.
Penutup
Mengoptimalkan GPU untuk AI membutuhkan pendekatan yang seimbang antara kecepatan dan stabilitas. VRAM, quantization, batch, context, CPU, RAM, transfer data, temperatur, driver, dan framework harus dikelola agar tidak saling menciptakan bottleneck. Dengan memahami hubungan antarbagian tersebut, pengguna dapat meningkatkan kecepatan tanpa memberikan tekanan berlebihan pada sistem.
Monitoring menjadi bagian penting dalam menemukan konfigurasi terbaik. Masing masing workload memiliki karakter penggunaan sumber daya yang tidak sama, sehingga optimasi sebaiknya dilakukan secara bertahap. TEKNOLOGI berbasis GPU dapat mencapai performa yang lebih stabil ketika sumber daya dikelola dengan tepat. Pengguna dapat membandingkan hasil setiap konfigurasi agar menemukan pengaturan paling sesuai.