AI Inference Engine Optimization Dorong Era On-Device AI yang Lebih Cepat dan Efisien
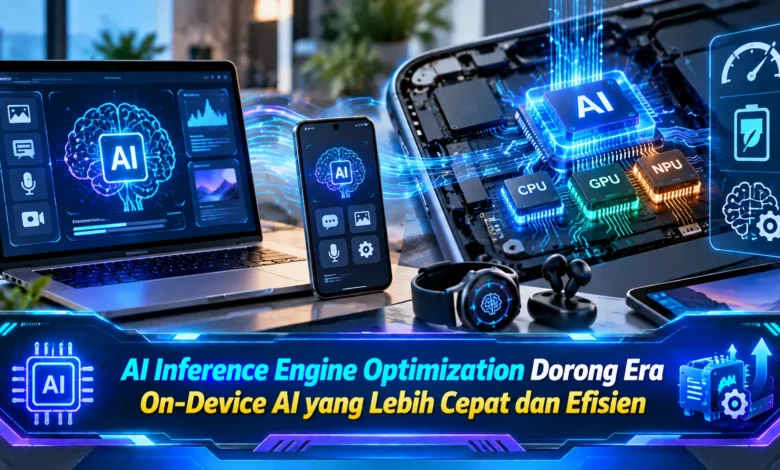
Perkembangan AI mulai bergerak semakin dekat ke perangkat pengguna melalui konsep on device AI. Smartphone, laptop, wearable, kendaraan, dan berbagai perangkat pintar kini membutuhkan kemampuan menjalankan model kecerdasan buatan secara cepat tanpa selalu bergantung pada pemrosesan cloud. AI Inference Engine Optimization menjadi bagian penting dalam perubahan tersebut karena teknologi ini membantu model memanfaatkan CPU, GPU, NPU, memori, dan sumber daya perangkat secara lebih efisien sehingga pengalaman AI lokal dapat terasa semakin responsif.
Optimalisasi Inference Membuka Jalan bagi AI yang Berjalan di Perangkat
AI Inference Engine Optimization bekerja dengan mengatur proses eksekusi model agar dapat memanfaatkan kemampuan perangkat secara lebih efektif. Ketika proses pelatihan model telah selesai, perangkat menggunakan inference untuk memproses input baru dan memberikan hasil yang sesuai. Tahap tersebut dapat melibatkan banyak operasi matematika sehingga kecepatan hardware saja belum tentu cukup apabila alur komputasinya tidak dioptimalkan.
Dalam penerapan on device AI, efisiensi menjadi semakin penting karena perangkat harus bekerja dengan keterbatasan baterai, memori, termal, dan kemampuan komputasi. Sistem inference dapat menyesuaikan alur model, menentukan metode eksekusi, menggunakan hardware accelerator, dan mengurangi overhead yang tidak dibutuhkan. Mekanisme ini menunjukkan bahwa teknologi on device AI membutuhkan perpaduan hardware yang memadai dan software yang mampu menggunakan sumber daya secara optimal.
On Device AI Memanfaatkan Berbagai Unit Komputasi secara Efisien
Perangkat modern dapat memiliki beberapa jenis unit pemrosesan dengan karakteristik yang berbeda. CPU berperan sebagai prosesor serbaguna, GPU menawarkan paralelisme tinggi, sedangkan NPU memiliki kemampuan khusus untuk menangani beban kerja kecerdasan buatan. Kemampuan yang berbeda memungkinkan mesin inference membagi operasi berdasarkan kekuatan masing masing unit pemrosesan.
Pembagian workload yang tepat dapat membantu menghindari kondisi ketika seluruh proses AI dibebankan kepada satu jenis prosesor. CPU dapat menangani logika dan pekerjaan umum, GPU dapat menjalankan komputasi paralel, sementara NPU dapat digunakan untuk operasi AI yang sesuai. Mesin inference tetap harus memperhitungkan perpindahan informasi antarprosesor karena distribusi workload yang berlebihan dapat menambah overhead. Dengan penjadwalan yang tepat, teknologi on device AI dapat memanfaatkan kombinasi hardware secara lebih seimbang untuk meningkatkan performa sekaligus menjaga penggunaan daya.
Operator Fusion Membuat Proses AI Lokal Lebih Efisien
Model kecerdasan buatan dapat terdiri dari sejumlah operasi matematika yang saling berhubungan dalam sebuah graph komputasi. Inference engine dapat menganalisis struktur tersebut untuk mencari bagian yang dapat disederhanakan, digabungkan, atau dieksekusi dengan metode yang lebih efisien. Langkah ini dilakukan untuk menekan proses tambahan tanpa menghilangkan fungsi yang diperlukan oleh model.
Operator fusion dapat digunakan untuk menggabungkan beberapa tahap komputasi sehingga eksekusinya tidak harus dilakukan secara terpisah. Cara tersebut dapat mengurangi perpindahan informasi berulang antara unit komputasi dan sistem memori. Dengan mengurangi overhead, berbagai unit pemrosesan dapat mengalokasikan kapasitas yang lebih besar untuk operasi model yang benar benar diperlukan. Pendekatan tersebut membuat teknologi AI lokal dapat memperoleh peningkatan efisiensi tanpa harus terus mengandalkan hardware yang semakin kuat.
Quantization Membuat Model AI Lebih Ringan untuk Perangkat Lokal
Salah satu pendekatan penting dalam optimalisasi inference adalah quantization karena model kecerdasan buatan memproses sejumlah besar nilai numerik. Representasi angka yang lebih efisien dapat mengurangi ukuran data serta jumlah sumber daya komputasi yang dibutuhkan. Data yang lebih ringkas juga dapat mengurangi tekanan terhadap bandwidth memori karena jumlah informasi yang harus dipindahkan menjadi lebih kecil.
Efisiensi quantization dapat menjadi lebih tinggi ketika unit komputasi mendukung format data yang telah dioptimalkan. Namun, pengurangan presisi tetap perlu dievaluasi karena konfigurasi yang terlalu agresif dapat memengaruhi kualitas keluaran model. Mesin inference perlu menyeimbangkan kecepatan pemrosesan, ukuran model, penggunaan memori, konsumsi energi, serta ketepatan hasil. Hal ini menjadi penting untuk teknologi on device AI karena peningkatan performa perlu dicapai tanpa membuat konsumsi energi menjadi terlalu tinggi.
AI Lokal Membutuhkan Keseimbangan Performa dan Konsumsi Energi
Kecepatan prosesor bukan satu satunya faktor yang menentukan performa on device AI karena aliran data antara memori dan unit komputasi juga memiliki peran besar. Hardware berperforma tinggi dapat mengalami waktu tunggu apabila parameter model maupun data tidak tersedia ketika dibutuhkan. Oleh sebab itu, mesin inference dapat mengatur buffer, merencanakan alokasi, menentukan urutan komputasi, dan menggunakan kembali memori sementara.
Efisiensi daya juga menjadi perhatian karena proses AI yang berlangsung terus menerus dapat memengaruhi baterai serta suhu perangkat. Sistem dapat memilih unit pemrosesan berdasarkan kebutuhan serta mengelola workload agar hardware tidak bekerja terlalu berat untuk tugas yang sebenarnya ringan. Pendekatan tersebut membuat teknologi on device AI lebih cocok digunakan pada smartphone, laptop, wearable, dan perangkat pintar yang harus menyeimbangkan kecepatan dengan daya tahan baterai.
Kesimpulan
AI Inference Engine Optimization memiliki peran besar dalam mendorong on device AI karena perangkat lokal harus menjalankan model secara responsif tanpa menggunakan sumber daya secara berlebihan. Distribusi pekerjaan pada CPU, GPU, dan NPU memungkinkan hardware digunakan berdasarkan kekuatannya, sementara optimalisasi graph dan penggabungan operator membantu menekan overhead. Quantization kemudian membantu mengurangi kebutuhan memori serta komputasi, sementara manajemen memori memastikan aliran data dapat berlangsung secara lebih efisien. Apabila berbagai optimalisasi tersebut berjalan bersama pengaturan energi yang tepat, teknologi on device AI dapat memberikan respons lebih cepat dengan penggunaan sumber daya yang lebih terkontrol. Kemajuan tersebut memberikan peluang bagi berbagai kemampuan AI untuk diproses secara lokal sehingga ketergantungan terhadap cloud dapat dikurangi pada fungsi yang sesuai. Anda dapat mengikuti perkembangan teknologi AI Inference Engine Optimization sekaligus berdiskusi mengenai kemampuan on device AI yang paling dibutuhkan pada perangkat masa depan.